Microsoft فتحت مصدر Agensh: 1024 وكيل برمجة بلا منسّق مركزي
يوم 24 تشرين الأول فتحت Microsoft Research مصدر Agensh برخصة MIT: إطار عمل بيوصل فرق وكلاء البرمجة لـ 1024 وكيل بلا منسّق مركزي، وبنتائج قياس منشورة على أصعب مهام ProgramBench.
لما بتشغّل فريق وكلاء برمجة، المنسّق المركزي بيصير عنق زجاجة: كل وكيل بيستناه، وكل قرار بيمر من عنده. Microsoft Research فتحت مصدر Agensh برخصة MIT يوم 24 تشرين الأول 2026، وهو إطار عمل بيشيل هالمنسّق ومجرّب لحد 1024 وكيل. وأرقامه منشورة مع دليل بيخليك تعيد التجربة بنفسك.
شو هو Agensh؟
Agensh هو إطار عمل لفريق وكلاء بينظّم حاله بنفسه، وبيوسع لحد 1024 وكيل. الوكلاء بيكتشفوا المهام الفرعية وبيحجزوها، وبيشاركوا النتائج وبيتحققوا منها، وبيدمجوا شغلهن كل واحد على وقته، بلا منسّق مركزي.
كل وكيل بيمشي على نفس الحلقة: بيجمع السياق، وبيحجز مهمة فرعية، وبينفّذ، وبيتحقق من النتيجة، وبيدمج تقدّمه، وبيرجع يكرر لحد ما يوصل لهدف المستخدم. والبنية المشتركة بينهن تلات أشياء: مساحة عمل مشتركة على Gitea، وواجهة رسائل على Mattermost، ولوحة سياق مشتركة مأخوذة من DeLM. بالتجربة المنشورة، كل وكيل شغّال فوق حلقة الوكيل تبع Copilot CLI.
لما ما في منسّق مركزي، ما في نقطة وحدة إذا وقفت بيوقف الفريق كله، والوكلاء بيشتغلوا بالتوازي على مهام فرعية مختلفة. وحسب المستودع، كل الوكلاء بيبلّشوا بنفس الدور، وأدوار متخصصة وطرق تنسيق بتطلع لحالها كل ما كبر الفريق.
شو أثبتت التجربة بالأرقام؟
على أصعب خمس مهام بـ ProgramBench، متوسط نسبة نجاح الاختبارات طلع من 19.31% بوكيل واحد لـ 28.78% بـ 128 وكيل، يعني تحسّن نسبي حوالي 49%.
ProgramBench بيطلب من الوكلاء يعيدوا بناء برامج مرجعية من سلوكها الملاحظ ووثائقها المرفقة، بلا إنترنت وبميزانية ست ساعات. والرقم بالتجربة هو نسبة الاختبارات يلي بتمرق عالبرنامج الجديد. النموذج كان GPT-5.6-sol بجهد استدلال عالي، والأرقام كلها من مستودع Agensh.
عدد الوكلاء | المتوسط على 5 مهام | Pandoc |
|---|---|---|
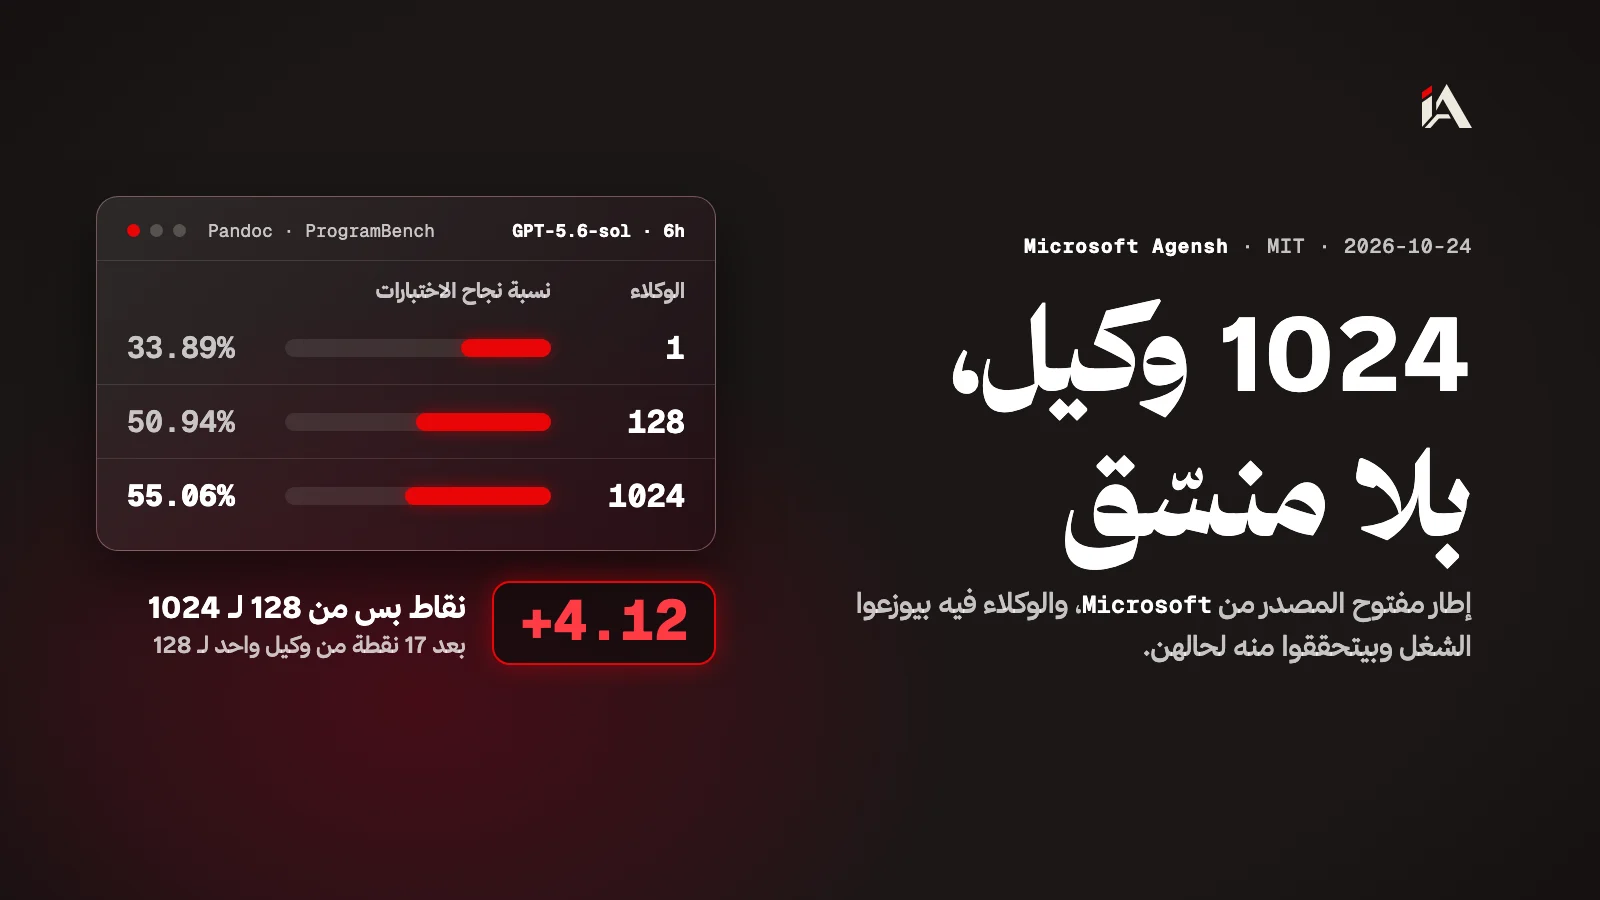
1 | 19.31% | 33.89% |
128 | 28.78% | 50.94% |
1024 | غير مذكور بالمتوسط | 55.06% |
على Pandoc، النسبة زادت حوالي 17 نقطة من وكيل واحد لـ 128 وكيل، وبعدها حوالي 4 نقاط بس من 128 لـ 1024.
وبنتيجة أحدث بالمستودع مع GPT-6.1-sol، نسبة Pandoc طلعت من 56.19% بوكيل واحد لـ 79.59% بـ 32 وكيل، يعني تحسّن نسبي 41.64%. المستودع ما نشر أرقام لهالنموذج فوق 32 وكيل.
شو الجديد يوم 24 تشرين الأول، وشو مش جديد؟
الجديد هو الكود نفسه، أما الورقة البحثية فمنشورة على arXiv من 22 أيلول 2026.
قسم الأخبار بالمستودع بيقول: «2026-10-24: فتحنا مصدر Agensh، بما فيه الإطار وسكربتات إطلاق التجارب ودليل إعادة الإنتاج». الإصدار فيه إعداد فريق بعقدة وحدة بـ Docker Compose وخط أساس بوكيل واحد مستقل، والتنين بيستعملوا جلسات Copilot ACP الأصلية.
يعني إذا قريت عن Agensh كأنه بحث طالع هالأسبوع، الورقة الأولية من أيلول والكود من 24 تشرين الأول. والكود هو يلي بيخليك تعيد التجربة بنفسك. بس الدليل نفسه بيقول إنو بنية الإصدار اتحدّثت عن التجربة الأصلية، فرقمك ممكن ما يطلع نفس الرقم المنشور بالضبط.
كيف بتجرّبه بنفسك؟
دليل إعادة الإنتاج بالمستودع بيشغّل تجارب ProgramBench نفسها: فريق بعقدة وحدة، وخط أساس بوكيل واحد بتقارن فيه.
انسخ المستودع
microsoft/Agenshمن GitHub.جهّز جهاز Linux فيه Docker Compose، ونزّل ProgramBench لحاله، حسب دليل إعادة الإنتاج. الإعداد الافتراضي 8 وكلاء و6 ساعات لكل مهمة على gpt-5.6-sol، فبدك بوابة نموذج بتخدمه ومفتاحها.
شغّل إعداد الفريق بعقدة وحدة بـ Docker Compose.
شغّل خط الأساس بوكيل واحد على نفس المهمة، وقارن نسبة نجاح الاختبارات والوقت بالأرقام.
إذا بدك توسّع، وسّع بالتدريج: من وكيل واحد لـ 8، وبعدين لـ 32، وقيس عند كل خطوة، لأن الأرقام المنشورة ما بتطلع دايماً لفوق مع كل زيادة: بمهمة ctags، 8 وكلاء جابوا 18.47% مقابل 25.82% لوكيل واحد.
لا تحط Agensh بنفس خانة أدوات البرمجة اليومية. ومن المشاريع القريبة منه Infinity يلي فتحت مصدرها AWS، وهي بتحل مشكلة تانية: كيف الوكيل بيستنى نتيجة الأداة بلا ما يصرف حوسبة. وAgensh بيحل كيف ألف وكيل بيتنسّقوا مع بعض. التنين مفتوحين المصدر، والتنين لفرق عم تبني بنية وكلاء.
إمتى ما بيناسبك؟
إذا شغلك وكيل واحد على مهمة واضحة ومحدودة، Agensh تعقيد زيادة بلا فايدة.
وإذا ما عندك خبرة بتشغيل فرق وكلاء وقياس نتائجها، الإطار البحثي رح ياخد منك وقت إعداد أكتر من يلي بيعطيك ياه. أرقامه كمان مقاسة على حلقة Copilot CLI، فإذا فريقك بيشتغل بأداة وكلاء تانية، الأرقام المنشورة ما بتنطبق عليك مباشرة.
بس إذا عندك إعادة هيكلة كبيرة أو ترحيل قاعدة كود كاملة، وعندك فريق بيقيس شغله بالأرقام، Agensh مرجع تصميم مجاني ومفتوح المصدر لتجربة التوسّع بلا منسّق مركزي. جرّبه على مهمة صغيرة أول، وقيس، وبعدين قرّر إذا التوسّع بيستاهل.
وإذا كنت عم تبني وكلاء برمجة أصلاً، Kimi K3.1 Pro بيهمك من جهة النماذج: أرقام Moonshot بتحطه قريب من Claude بالبرمجة، ووعدت تنزّل أوزانه المفتوحة لحد 4 تشرين الثاني.
ولأدوات ومهارات جاهزة لوكلاء البرمجة، شوف قسم مهارات AI.
أسئلة شائعة
هل Agensh منتج جاهز بشغّله على مشروعي مباشرة؟
لأ. هو إطار عمل بحثي مفتوح المصدر، والإصدار مبني لإعادة تجارب ProgramBench: فريق بعقدة وحدة على Docker Compose، وخط أساس بوكيل واحد، ودليل إعادة إنتاج. والدليل ما بيشرح تشغيله على كود مشروعك.
هل الورقة البحثية جديدة؟
لأ. الورقة الأولية اننشرت على arXiv يوم 22 أيلول 2026. الجديد يوم 24 تشرين الأول هو فتح مصدر الكود نفسه: الإطار وسكربتات إطلاق التجارب ودليل إعادة الإنتاج.
هل وكيل أكتر يعني نتيجة أحسن دايماً؟
مش دايماً. المتوسط على المهام الخمس تحسّن عند كل حجم فريق انقاس، بس على ctags، 8 وكلاء جابوا 18.47% مقابل 25.82% لوكيل واحد. وعلى Pandoc النسبة طلعت من 33.89% بوكيل واحد لـ 50.94% بـ 128 وكيل ولـ 55.06% بـ 1024، يعني القفزة الكبيرة صارت قبل الـ 128. والتكلفة ما انذكرت.
هل Agensh بيشتغل مع غير Copilot؟
مش بالإصدار الحالي. التجربة المنشورة مبنية على حلقة الوكيل تبع Copilot CLI، والإصدار بيستعمل جلسات Copilot ACP الأصلية. الورقة بتقول إنو التصميم بيركب على أدوات تانية متل Claude Code بمحوّل صغير لكل أداة، بس الإصدار المنشور ما فيه محوّل لغير Copilot.