بدك تعرف طول طلبك لـ Claude قبل ما تبعته؟ عدّ التوكنز
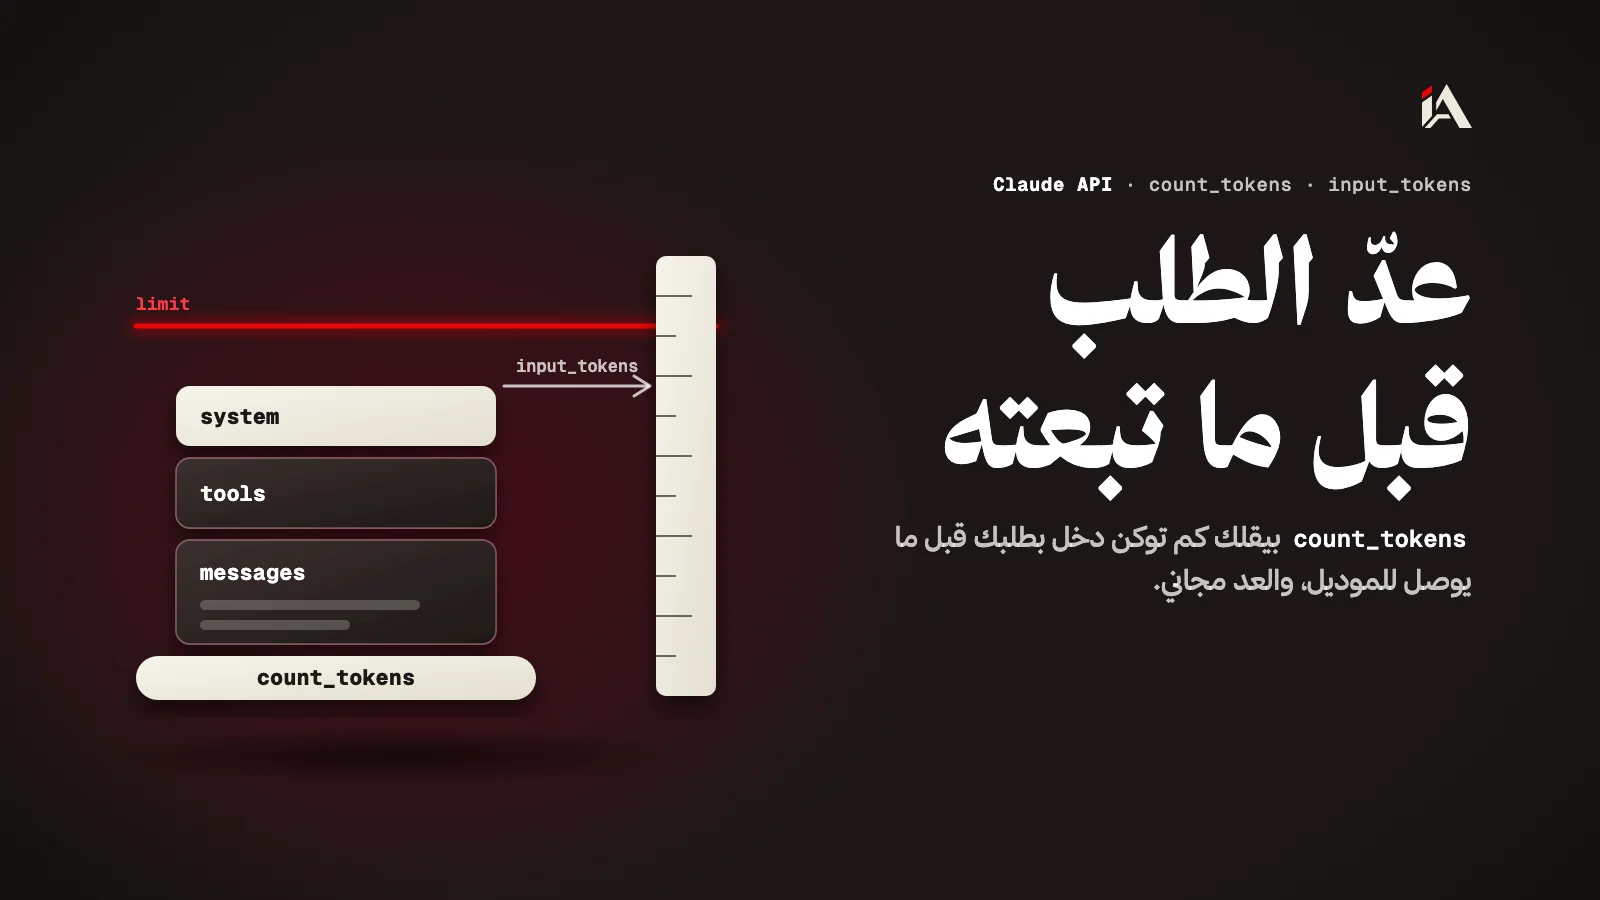
نقطة count_tokens بـ Claude API بتقلك كم توكن دخل بطلبك قبل ما تبعته، بنفس شكل طلب الرسالة. العد مجاني، وحدّه منفصل عن حد الرسائل.
بتبعت طلب لـ Claude، وبعد ما يرجع الجواب بتعرف قديش كان طوله: حقل الـ usage بيقلك كم توكن دخل. إذا الطلب كان أطول من يلي بتتوقعه، الكلفة صارت. بهالمقال رح تعرف كيف تعدّ التوكنز قبل ما تبعت، وإمتى هالعد بيفرق بقرارك.
شو هو عدّ التوكنز بـ Claude API؟
عدّ التوكنز نقطة بالـ Claude API بتاخد نفس محتوى طلب الرسالة، وبترجّعلك عدد توكنز الإدخال فيه، بلا ما تبعت الطلب للموديل.
حسب صفحة عدّ التوكنز بتوثيق Claude، العد بيخليك تعرف عدد التوكنز برسالة قبل ما تبعتها، لحتى تدير حدود الاستعمال والكلفة من قبل، وتختار الموديل المناسب، وتظبط الطلب على طول معيّن. النقطة اسمها /v1/messages/count_tokens، وبتقبل نفس مدخلات إنشاء رسالة، مع الـ system prompt والأدوات والصور وملفات الـ PDF.
كيف بتعدّ التوكنز بطلب؟
بتعدّ التوكنز لما تبعت نفس الـ model والـ system والـ messages يلي ناوي تبعتهن، بس لـ count_tokens بدل create.
هاد مثال التوثيق نفسه بـ Python:
import anthropic

client = anthropic.Anthropic()

response = client.messages.count_tokens(
    model="claude-opus-5-5",
    system="You are a scientist",
    messages=[{"role": "user", "content": "Hello, Claude"}],
)

print(response.json())
والجواب حقل واحد:
{ "input_tokens": 14 }الرقم تقدير: التوثيق بيقول إنو العدد الحقيقي وقت إنشاء الرسالة ممكن يختلف بشي بسيط ببعض الحالات. وإذا العد فيه توكنز ضافتها Anthropic لحالها، هدول ما بتدفع حقهن.
شو ما بيقبل count_tokens؟
الـ count_tokens بيرجّع invalid_request_error على شوية مدخلات بيقبلها Messages API: أدوات السيرفر، والـ MCP connector، والصور والملفات يلي مصدرها url أو file.
بالتفصيل، حسب نفس الصفحة:
أدوات السيرفر متل البحث بالويب وجلب الصفحات وتشغيل الكود، كلها إلا أداة الـ advisor.
الـ MCP connector.
بلوكات
imageأوdocumentيلي مصدرهاurlأوfile. لتعدّها، ابعت الصور والـ PDF بـ base64.
ولطلبات فيها أدوات سيرفر أو MCP، العدد بيجيك بحقل الـ usage بجواب Messages API بعد الطلب.
ليش لازم تعيد العد لما تغيّر الموديل؟
لازم تعيد العد لأنو نفس النص بيطلع بعدد توكنز مختلف حسب الموديل، فالرقم يلي قسته على موديل قديم ما بيصلح لموديل أحدث.
التوثيق بيقول إنو موديلات Claude 4.7 وبعدها بتستعمل طريقة تقطيع أحدث، ونفس النص بيطلع فيها تقريباً 30 بالمية توكنز أكتر من الموديلات قبلها، والزيادة بالزبط بتعتمد على المحتوى. ونصيحته: عدّ نفس الطلب مرتين، مرة بالموديل يلي عم تستعمله ومرة بالموديل يلي ناوي تنقل عليه، وقارن قيمتي input_tokens.
قديش بيكلّف العد، وشو حدوده؟
العد مجاني، بس إلو حد طلبات بالدقيقة حسب مستوى حسابك، وهالحد منفصل عن حد إنشاء الرسائل.
نفس الصفحة بتقول إنو استعمال واحد منهن ما بينحسب من حد التاني. يعني فيك تعدّ كل طلب قبل ما تبعته بلا ما تاكل من حد الرسائل. وإذا عندك prompt caching، انتبه: العد بيعطي تقدير بلا منطق الكاش، والكاش بيصير بس وقت إنشاء الرسالة.
من وين تبلّش هلق؟
خود أطول طلب بتبعته بمشروعك، متل طلب فيه ملف كامل أو محادثة طويلة، ومرّقه على count_tokens قبل الإرسال. إذا ناوي تنقل لموديل أحدث، عدّه بالموديلين وقارن، وحط حد بالكود بيرفض أو بيقصّ الطلب قبل ما يتجاوز يلي بدك ياه.
وإذا نفس التعليمات بتتكرر بكل طلب، كمّل بـ تخزين التعليمات بـ prompt caching، وإذا وكيلك بيقرا محتوى من برّا، شوف كيف تحدّ أدوات وكيل الـ AI. ولمهارات جاهزة لـ Claude Code ووكلاء البرمجة، في قسم مهارات AI.
أطول طلب عندك، قديش توكن طلع؟
أسئلة شائعة
عدّ التوكنز بيكلّف شي؟
لأ. عدّ التوكنز مجاني، بس إلو حد طلبات بالدقيقة حسب مستوى حسابك، وهالحد منفصل عن حد إنشاء الرسائل.
الرقم يلي بيرجع دقيق؟
هو تقدير. التوثيق بيقول إنو العدد الحقيقي وقت إنشاء الرسالة ممكن يختلف بشي بسيط ببعض الحالات.
بيستعمل count_tokens الـ prompt caching؟
لأ. العد بيعطي تقدير بلا منطق الكاش، والكاش بيصير بس وقت إنشاء الرسالة الحقيقية، حتى لو حطيت cache_control بطلب العد.